Wer einen Linux-Cloud-Server für OpenClaw 2.0 bestellt und den Installer als Erfolgskriterium nimmt, kauft fast immer zu knapp. Das Gateway startet. Sobald ein Kanal hängt und ein Skill mitläuft, ist der available-RAM weg. Wir haben gängige VPS-Stufen auf demselben Ubuntu-Image durchgezogen — Native-Install, Docker, Remote-API, lokales Modell — und CPU, RAM sowie Festplatte protokolliert. Bestellen Sie nach Last, nicht danach, ob sich SSH öffnet.
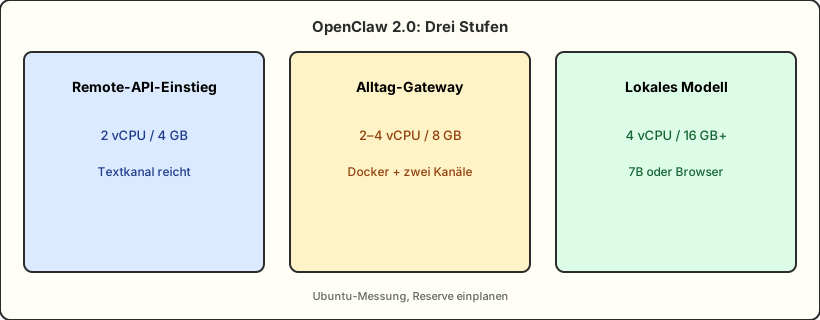
Die Kurzfassung: Remote-API plus Textkanal starten im Alltag bei 2 vCPU / 8 GB / 40 GB. 2 vCPU / 4 GB kommen hoch, aber ohne Browser-Skill und ohne Image-Build auf derselben Box. Soll ein 7B-Modell mitlaufen, planen Sie RAM sofort mit 16 GB. Die offizielle Doku denkt den Gateway als selbst gehosteten, mehrkanaligen Agenteneingang — Spielraum über dem Wortlaut-Minimum ist deshalb Teil der Spez, nicht Luxus.
Nach Last wählen, nicht nach dem Billigsten
Der OpenClaw-2.0-Prozess selbst ist schlank. Im Leerlauf liegt das Gateway oft bei zwei- bis dreihundert MB, die CPU klebt an 0. Die Maschine kippt, wenn drei Dinge zusammenkommen: die erste Sandbox-Kompilierung, ein Docker-Build auf dem Host und lokale Inferenz. Die OpenClaw-Docker-Installationsdoku sagt klar: Image-Build aus dem Quellcode braucht mindestens 6 GB RAM. Das vorgebaute Image ghcr.io/openclaw/openclaw spart genau diese Spitze.
Deshalb ist 4 GB gegen 16 GB kein Tempo-Unterschied, sondern der Unterschied zwischen „es lebt“ und „es arbeitet“. Die Grafik darunter ist die Einkaufsschnittung in drei Stufen.
So haben wir die Testumgebung angeglichen
Dasselbe Ubuntu-Cloud-Image, nur CPU, RAM und Disk geändert — damit kein Generationssprung dem Gateway in die Schuhe geschoben wird. Nach dem Setup zuerst apt update && apt upgrade, dann Node (offiziell Node 26 oder Node 24.16+), Git und Docker Compose v2. SSH nur mit Schlüssel. Wer neben Telegram oder Discord auch Matrix anbinden will, sollte die Kanalrechnung nicht erst nach dem Kauf aufmachen; die Checkliste steht in 2026 OpenClaw mit Matrix auf Linux-Cloud-VPS: Plugin, Homeserver, Token und Mehrraum-Routing.
Pro Stufe vier Zahlen: System-Leerlauf, Gateway-Leerlauf, Steady-State nach einem Telegram-Kanal, Peak nach einer Nachricht mit Tool-Call. Die Festplatte messen wir an der Ubuntu-Wurzel, an den Docker-Lagen und am Workspace ~/.openclaw. Median aus drei Läufen, kein „einmal hat es gerade gehalten“.
free -h available, nicht das aufgeblasene VIRT. CPU: 60-Sekunden-Mittel, keine Einzelkern-Spitze. Die Disk-Zahl enthält die Swap-Datei selbst nicht.
Was Ubuntu und Docker jeweils kosten
22.04 und 24.04 tragen OpenClaw 2.0. 24.04 braucht im Leerlauf etwa 100–200 MB mehr, bringt dafür einen frischeren Kernel und ein längeres LTS-Fenster. 22.04 gewinnt bei der Zahl der Troubleshooting-Posts. Eine Desktop-Umgebung gehört auf keine der beiden — die GUI frisst genau das eine GB, das Sie dem Gateway lassen wollten.
Docker hat zwei Posten. Die Engine liegt im Leerlauf bei etwa 150–250 MB. Das Image selbst: slim 1–2 GB Disk, die -browser-Variante mit Chromium noch eine Stufe mehr. curl -fsSL https://openclaw.ai/install.sh | bash ohne Container-Lage ist im Leerlauf dünner; Rollback heißt dann eigene Binär- und Config-Kopien. Auf 4 GB nur Native plus Remote-API. Docker ja, aber nur vorgebaut — kein docker build auf dieser Box.
Die Engine kommt aus dem offiziellen Repo, nicht aus veralteten Distro-Paketen. Schritte nach der offiziellen Docker-Ubuntu-Installation. Danach prüfen, dass docker compose als Plugin da ist und nicht das alte docker-compose-Binary. OpenClaw-Compose ist auf v2 geschrieben.
| Installationsweg | RAM im Leerlauf | Disk-Zuwachs | Für wen |
|---|---|---|---|
| Native install.sh | ca. 250–400 MB | ca. 0,4–0,8 GB | 4-GB-Versuch, minimale Last |
| Docker vorgebaut | ca. 450–700 MB | ca. 2–4 GB | 8-GB-Alltag, Isolation, Rollback |
| Image-Build auf dem Host | Peak ≥ 6 GB | Build-Cache extra | nur auf 8 GB+ oder CI |
Vier Spezifikationen im Messlauf: CPU, RAM, Festplatte
Das ist die Kernmatrix dieser Praxisrunde. Die CPU-Spalte fragt, ob der Scheduler hält. Die RAM-Spalte fragt nach OOM. Die Disk-Spalte fragt, ob nach der Installation noch Platz für Logs bleibt. Alles Remote-API, ein Kanal, kein lokales Modell.
| Spez | CPU | RAM | Festplatte | Fazit |
|---|---|---|---|---|
| 2C2G / 25 GB | plant, zittert bei Parallelität | available lange unter 300 MB | nach Install fast leer | nicht empfehlen, Docker-Build = OOM |
| 2C4G / 40 GB | ein Kanal reicht | Steady etwa 2,1–2,6 GB belegt | 40 GB knapp genug | nur Text, kein Browser |
| 2C8G / 80 GB | zwei Kanäle bleiben ruhig | available oft 3 GB+ | 80 GB bequem | erste Wahl für Remote-API |
| 4C16G / 160 GB | Tool-Call-Peaks ohne Warteschlange | 7B oder Browser, nicht beides | Modelldateien extra rechnen | kaufen, wenn lokal inferiert wird |
2C2G stirbt immer gleich: Gateway oben, available noch ein- bis zweihundert MB, dann eine Docker-Lage oder ein Onboard — Kernel-OOM, Exit 137, kaum Fachfehler in den Logs. 4 GB überlebt, aber nur wenn Browser-Skill und Host-Build aus bleiben und Log-Rotation an ist. Bei 8 GB taucht zum ersten Mal die Reserve auf, einen zweiten Kanal zu öffnen. 16 GB macht den Textchat nicht schneller. 16 GB berechtigt erst die Diskussion über lokale Modelle.
Die Festplatte füllt sich schneller, als viele einkalkulieren. Nach Ubuntu-Updates stehen 8–12 GB auf der Wurzel, Docker-Images 2–6 GB, Workspace und Logs 1–5 GB im Monat. Offiziell heißt es ungefähr „Platz für Image und Logs lassen“. Betriebsfähig formuliert: ohne lokales Modell mindestens 40 GB, im Alltag 80 GB, plus 10–20 GB für ein Host-Modell. 2–4 GB Swap sind Versicherung, kein RAM-Plan. Liegt die Last im Swap, wird die Tail-Latenz der Tool-Calls spürbar schlechter.
Lokales Modell vs. Remote-API: so rechnen Sie
Die Remote-API zieht die Inferenz vom VPS. Die Maschine behält Gateway, Kanal und Tools. Das ist der hardwareärmste Weg; die offizielle OpenClaw-Dokumentation setzt voraus, dass Sie den Schlüssel eines Modell-Anbieters selbst mitbringen. Der Preis: Token-Rechnung, und der Kontext verlässt die Box. Wer die Preisentwicklung der großen APIs mitdenkt, findet die Einordnung in GPT-6 API: Erwartete Preise, Funktionen und Migrationsleitfaden (2026).
Ein lokales Modell tauscht die Rechnung gegen RAM. 7B-Quant-Gewichte liegen bei etwa 4–5 GB; plus Ollama-Runtime und KV-Cache teilt sich das 16-GB-System gerade noch mit dem Gateway. 14B denken Sie in 32 GB. Qualität, Tool-Following und langer Kontext werden dabei sichtbar dünner.
Grobe Monatsschätzung zu üblichen Linux-Cloud-Listenpreisen 2026 (US-Dollar, ohne Traffic-Überzug):
| Variante | Maschinenmiete/Monat | Modellrechnung | Größenordnung | Geeignet |
|---|---|---|---|---|
| 2C8G + Remote-API | ca. 10–18 | leicht 15–40, heavy höher | 25–60 | persönlicher Assistent, unkritischer Kontext |
| 4C16G + lokal 7B | ca. 20–40 | 0 | 20–40 | viel Tagesvolumen, Daten bleiben auf der Box |
| 8C32G + lokal 14B | ca. 40–80 | 0 | 40–80 | Qualität näher an mittleren Cloud-Modellen |
„Lokal ist immer billiger“ hält der Buchhaltung nicht stand. Ein paar hundert kurze Dialoge im Monat kosten auf der API oft weniger als der Sprung von 8 GB auf 16 GB. Umgekehrt: stündliche Cron-Runden, hunderte Kanalnachrichten am Tag oder Logs, die das Netz nicht verlassen dürfen — dann tilgt 16 GB + 7B zuerst die API-Rechnung und lässt die Daten auf der Maschine.
Der Kompromiss, den wir öfter empfehlen: das Hauptmodell bleibt remote, Titel und Kurzfassungen wandern auf das Utility-Kleinmodell aus der Doku oder gelegentlich auf ein Host-7B. Browser-Skill und lokales 14B gleichzeitig auf einer 8-GB-Maschine gehen in der RAM-Rechnung nicht auf.
Entscheidungstabelle für die Bestellung
Schreiben Sie die gewünschte Fähigkeit als Menge von Bedingungen, die gleichzeitig gelten müssen. Beißen sich die Bedingungen, sind zwei Maschinen billiger und leichter zu debuggen als eine Box, die Browser und 14B gleichzeitig tragen soll.
| Gewünschte Fähigkeit | Minimum zum Start | Empfehlung | Klar vermeiden |
|---|---|---|---|
| Telegram- / Discord-Textassistent | 2C4G native | 2C8G + Docker vorgebaut | Host-Build, Desktop |
| plus Browser-Skill | 4C8G | 4C8G oder 4C16G | zusammen mit lokalem 14B |
| lokale 7B-Inferenz | 4C16G | 4C16G NVMe 80 GB+ | 8 GB „wird schon“ |
| Team, mehrere Kanäle, Audit-Logs | 4C8G | 4C8G / 80–160 GB | keine Log-Rotation |
Zwei Dinge sehen aus wie „zu wenig RAM“, obwohl die Spez stimmt: Gateway auf 0.0.0.0 ohne Reverse-Proxy, und eine volle Log-Disk. Ersteres binden Sie auf 127.0.0.1 und stellen Nginx oder Caddy davor. Zweiteres bekommt Größenlimits für Docker und journald. Nach dem richtigen Kauf entscheiden genau diese zwei Punkte, ob Sie nächste Woche um 3 Uhr die Festplatte erweitern.
FAQ
Reichen 1C1G oder 2C2G zum Ausprobieren?
Nur um zu sehen, ob das Install-Skript durchläuft. Mit Kanal wackelt das Gateway, ein Docker-Build endet fast immer mit 137. Test mindestens 4 GB, zum Bleiben direkt 8 GB.
Muss es Ubuntu sein — geht Debian?
Debian 12 läuft, Docker offiziell ebenfalls. Ubuntu haben wir genommen, weil Images, Doku und Störungstexte zusammenpassen. Kein Non-LTS-Desktop als Produktionsersatz.
Ist die CPU der Engpass oder der RAM?
Bei Remote-API fast immer RAM und Festplatte. CPU wird zur ersten Warnlinie nur bei lokaler Inferenz, Browser-Rendering oder Host-Build. 4 vCPU sind für ein Text-Gateway Luxus, für 14B Pflicht.
Normale SSD oder NVMe?
Remote-API merkt die Disk kaum. Modell-Load und Docker-Lagen schon. 80 GB NVMe schlagen 160 GB langsame Disk — wenn die Log-Rotation läuft.
Gateway auf Linux, Steuerung auf dem Cloud-Mac-mini
Ein dauerhaft laufendes OpenClaw-Gateway gehört auf den Linux-VPS: günstig, Standard-Images, viel Docker-Material. Sobald dieselbe Kette Safari-Abnahme, Xcode-Signierung oder eine selten abstürzende Rufbereitschaft braucht, macht eine Extra-Last auf der schon vollen Linux-Box die RAM-Rechnung wieder rot. Unified Memory auf Apple Silicon, rund 4 W im Standby, macOS für langen unbeaufsichtigten Betrieb — das sind drei andere Achsen als „noch eine 32-GB-Linux-Stufe“.
Die robuste Teilung: Linux-Cloud nur Gateway und Remote-API, Cloud-Mac-mini nur natives macOS für Build und Desktop-Automation. Homebrew, Docker und SSH sind auf dem Mac sofort da. Sie müssen keinen Browser-Skill gegen Ollama um dieselbe RAM-Menge feilschen.
Steht die Linux-Stufe nach diesem Text, fehlt oft noch ein Steuerknoten, der sich nicht mit der Inferenz um Speicher streitet. Genau dort sitzt der VPSSpark-Cloud-Mac-mini M4. Tarife jetzt ansehen — eine Maschine extra pro Woche oder Monat ist leichter zu debuggen als alle Prozesse auf einem VPS.