Louer un serveur Linux pour OpenClaw 2.0, le piège n’est presque jamais l’installateur : c’est le palier trop juste. La Gateway se lève, on branche un canal, on lance une skill, et la mémoire disponible s’évapore. On a rejoué, sur les specs VPS courantes sous Ubuntu, l’install native, Docker, l’API distante et un modèle local, pour commander selon la charge réelle — pas selon « SSH répond ».
Le verdict d’abord : texte + API distante, 2 vCPU / 8 GB / 40 GB est le point de départ quotidien plus sûr ; 2 vCPU / 4 GB démarre, mais sans skill navigateur ni construction d’image sur la machine. Pour un 7B local sur le même hôte, visez 16 GB. La documentation OpenClaw pose la Gateway comme entrée agent auto-hébergée, multi-canaux, conçue pour « une machine à vous » : la marge compte plus que le minimum littéral.
D’abord la charge, pas le prix le plus bas
Le processus OpenClaw 2.0 lui-même n’est pas lourd. Idle, la Gateway tient souvent deux à trois cents Mo, le CPU colle presque à 0. Ce qui plombe la machine, c’est le cumul : premier démarrage qui compile le sandbox, docker build sur l’hôte, et inférence locale. La doc d’installation Docker OpenClaw le dit sans détour : construire l’image depuis les sources demande au moins 6 GB RAM ; tirer ghcr.io/openclaw/openclaw préconstruit évite ce pic.
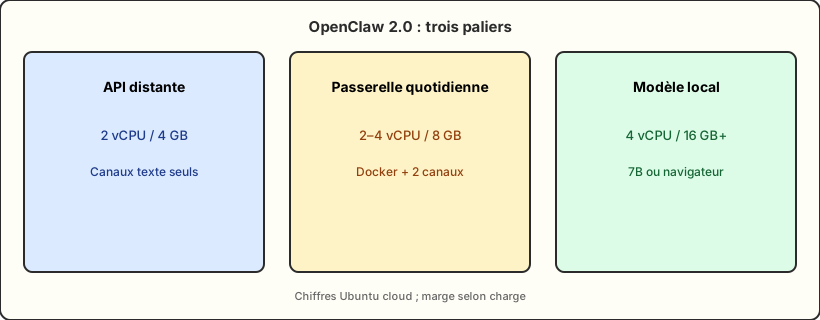
Sur 4 GB et 16 GB, ce n’est donc pas « un peu plus lent » : c’est « ça survit » contre « ça travaille ». Le schéma ci-dessous est la coupe à trois paliers qu’on donne aux achats.
Comment le labo a été aligné
Même image Ubuntu cloud, on ne change que CPU, RAM et disque, pour ne pas facturer à OpenClaw un écart de génération de machine. Après install : apt update && apt upgrade, puis Node (Node 26 recommandé, ou 24.16+), Git et Docker Compose v2. SSH en clés seulement. Si vous isolez aussi un outillage IA à cycle court sur un Mac cloud plutôt que d’empiler secrets et egress sur ce VPS, voir 2026 — essais d’outillage IA à court cycle et rafales batch : Mac cloud quotidien vs VPS léger — matrice isolation, egress et secrets (FAQ) avant d’ajouter encore une skill sur la même RAM.
À chaque palier, quatre relevés : idle système, idle Gateway, régime après un canal Telegram, pic après un message avec appel d’outil. Disque : racine Ubuntu, couches d’image Docker, workspace ~/.openclaw. On prend la médiane de trois mesures, pas le run « qui n’a pas crashé par chance ».
free -h, pas le VIRT gonflé. CPU : moyenne sur 60 s, pas un spike d’un cœur. Le disque n’inclut pas le fichier swap lui-même.
Ce que Ubuntu et Docker prennent chacun
Ubuntu 22.04 et 24.04 font tous deux tourner OpenClaw 2.0. 24.04 idle environ 100–200 MB de plus, contre un noyau plus récent et une fenêtre LTS plus longue ; 22.04 a davantage de fils de dépannage. Ni l’un ni l’autre ne devrait porter un bureau graphique : sur un cloud, le desktop avale le gigaoctet que vous croyiez réserver à la Gateway.
Docker se paie en deux factures. Moteur idle : environ 150–250 MB. Image : slim 1–2 GB disque, la variante -browser avec Chromium grimpe encore. L’install curl -fsSL https://openclaw.ai/install.sh | bash n’a pas de couches conteneur, idle plus mince, mais le rollback est à vous (binaire + copie de config). Sur 4 GB on ne recommande que native + API distante ; pour Docker, tirez l’image préconstruite, ne faites pas de docker build ici.
Installez Docker Engine depuis le dépôt officiel, pas le paquet périmé de la distro. Suivez la doc officielle Docker pour Ubuntu, puis vérifiez le plugin docker compose — pas le binaire docker-compose. Le flux Compose d’OpenClaw est écrit pour v2.
| Chemin d’install | RAM idle | Disque en plus | Pour qui |
|---|---|---|---|
| install.sh natif | env. 250–400 MB | env. 0,4–0,8 GB | Essai 4 GB, overhead mini |
| Image Docker préconstruite | env. 450–700 MB | env. 2–4 GB | Quotidien 8 GB, isolation / rollback |
| Build d’image sur l’hôte | pic ≥ 6 GB | cache de build en plus | 8 GB+ ou machine CI seulement |
Quatre paliers mesurés : CPU, RAM, disque
Le tableau suivant est le cœur de cette campagne OpenClaw 2.0. CPU : « est-ce que ça schedule ? ». RAM : « OOM ou pas ? ». Disque : « reste-t-il de la place pour les logs ? ». Tout ça en API distante, un seul canal, sans modèle local.
| Palier | CPU | RAM | Disque conseillé | Verdict |
|---|---|---|---|---|
| 2C2G / 25 GB | schedule, tremble dès la concurrence | available longtemps sous 300 MB | plus rien après l’install | À éviter ; build Docker = OOM |
| 2C4G / 40 GB | un canal suffit | régime ~2,1–2,6 GB utilisés | 40 GB tout juste | Texte seul OK, pas de navigateur |
| 2C8G / 80 GB | deux canaux encore stables | available souvent 3 GB+ | 80 GB à l’aise | Choix quotidien, API distante |
| 4C16G / 160 GB | pics d’outils sans file | 7B ou navigateur, pas les deux | fichiers modèle à part | À prendre si vous inférez local |
Le 2C2G casse toujours pareil : Gateway up, available à 100–200 MB, un pull Docker ou un onboard et le noyau OOM, code 137, presque aucune erreur métier dans les logs. 4 GB vit, à condition d’éteindre le navigateur, d’interdire le build local et d’ouvrir la rotation des logs. 8 GB est le premier palier où « on peut encore ajouter un canal ». 16 GB n’accélère pas le chat texte : il vous autorise à parler de modèle local.
Le disque se remplit plus vite qu’on le croit. Après mises à jour, la racine Ubuntu tient déjà 8–12 GB ; images Docker 2–6 GB ; workspace et logs, 1–5 GB par mois. L’officiel dit surtout « laissez de la place pour images et logs » ; en exploitation on écrit : hors modèle local au moins 40 GB, quotidien 80 GB, plus 10–20 GB si les poids restent sur la machine. Un swap de 2–4 GB sert d’assurance, pas de plan mémoire — dès qu’on swappe, la latence de queue des outils se dégrade.
Modèle local vs API distante : comment compter
L’API distante sort l’inférence du VPS : la machine ne garde que Gateway, canaux et outils. C’est l’usage le plus économe en matériel ; la documentation officielle OpenClaw suppose d’ailleurs que vous apportez la clé d’un fournisseur. Le prix : tokens, et le contexte quitte l’hôte.
Le modèle local convertit la facture en RAM. Un 7B quantifié pèse environ 4–5 GB ; avec runtime Ollama et cache KV, 16 GB cohabite juste avec la Gateway ; un 14B se pense en 32 GB. TLS, tunnel SSH et NO_PROXY coinceront plus souvent que « le poids se télécharge-t-il ».
Ordre de grandeur mensuel 2026, VPS Linux courant (dollars, hors dépassement de trafic) :
| Montage | Loyer machine | Facture modèle | Total | Pour |
|---|---|---|---|---|
| 2C8G + API distante | env. 10–18 | léger 15–40, plus si intense | 25–60 | Assistant perso, contexte peu sensible |
| 4C16G + 7B local | env. 20–40 | 0 | 20–40 | Beaucoup d’appels / données qui restent |
| 8C32G + 14B local | env. 40–80 | 0 | 40–80 | Qualité plus proche d’un modèle cloud moyen |
On entend trop « le local est forcément moins cher ». Séparez les comptes : quelques centaines de courts dialogues par mois, et la facture API reste souvent sous le surcoût 8 GB → 16 GB. Le 7B local concède aussi qualité, suivi d’outils et long contexte. À l’inverse, cron d’inspection à l’heure pile, des centaines de messages canal par jour, ou des logs qui ne doivent pas sortir : 16 GB + 7B rattrape d’abord l’API, puis garde la donnée.
Le compromis qu’on préfère : Gateway sur le modèle distant principal, titres et micro-résumés sur le petit modèle utility, 7B local seulement par à-coups. N’ouvrez pas skill navigateur et 14B local sur le même 8 GB : la comptabilité RAM ne tient pas.
Comment commander : une table de décision
Écrivez les capacités qui doivent être vraies en même temps, puis commandez. Si elles se marchent dessus, deux machines coûtent moins cher — et se dépannent mieux — qu’un seul hôte qui veut le navigateur et le 14B. Quand le CI/CD iOS d’une équipe d’une vingtaine de personnes casse, c’est souvent le même réflexe de tout empiler ; voir Où le CI/CD iOS casse en premier quand l'équipe atteint 20 personnes.
| Capacité voulue | Minimum qui boot | Commande conseillée | À ne pas faire |
|---|---|---|---|
| Assistant texte Telegram / Discord | 2C4G install native | 2C8G + Docker préconstruit | Build sur l’hôte, bureau graphique |
| + skill navigateur | 4C8G | 4C8G ou 4C16G | Même machine qu’un 14B local |
| Inférence 7B locale | 4C16G | 4C16G NVMe 80 GB+ | Espérer qu’un 8 GB tienne |
| Multi-canaux équipe + audit | 4C8G | 4C8G / 80–160 GB | Logs sans rotation |
Deux sujets hors spec font croire à un manque de RAM : Gateway bindée sur 0.0.0.0 sans reverse proxy, et disque de logs plein. Liez 127.0.0.1 puis Nginx / Caddy ; plafonnez Docker et journald. Une fois le palier juste, ces deux réglages décident si vous élargissez le disque à 3 h du matin.
FAQ
1C1G ou 2C2G, ça sert à essayer ?
Seulement pour vérifier que le script d’install va au bout. Dès qu’un canal s’accroche, ça tremble ; un build Docker finit presque toujours en 137. Essai : 4 GB minimum. Pour rester : 8 GB d’emblée.
Ubuntu est-il obligatoire ? Debian suffit-il ?
Debian 12 tourne aussi, Docker officiel le documente. On a choisi Ubuntu pour les images faciles à trouver et l’alignement des fils de dépannage. Pas de desktop non-LTS en production.
Le goulot, c’est le CPU ou la RAM ?
En API distante, presque toujours RAM et disque. Le CPU ne devient la première alerte qu’en inférence locale, rendu navigateur ou build d’image. 4 vCPU est un luxe pour une Gateway texte, un besoin pour un 14B.
SSD classique ou NVMe ?
L’API distante se moque du disque. Chargement de modèle local et explosion des couches Docker sentent le NVMe. 80 GB NVMe vaut mieux que 160 GB lent, si la rotation des logs est ouverte.
Passerelle sur Linux, poste de contrôle sur Mac mini cloud
Le VPS Linux convient à une Gateway OpenClaw qui reste allumée : tarif bas, images standard, docs Docker partout. Dès qu’il faut aussi valider Safari, signer avec Xcode, ou tenir une machine de garde peu gourmande et peu crashy, ajouter encore de la charge sur le Linux déjà plein de Docker et de logs ramène la comptabilité RAM au point de départ. Mémoire unifiée Apple Silicon, idle d’environ 4 W, macOS pensé pour tourner sans surveillance : trois arguments d’une autre nature que « un palier Linux 32 GB de plus ».
La découpe plus saine : Linux cloud pour la Gateway et l’API distante, Mac mini cloud pour le build et l’automation qui exigent un macOS natif. Homebrew, Docker et SSH y sont prêts ; plus besoin de voler la RAM d’Ollama pour une skill navigateur.
Le palier Linux fixé, gardez un nœud de contrôle qui ne se bat pas avec l’inférence — c’est la place du Mac mini M4 cloud VPSSpark. Voir les offres, à la semaine ou au mois : plus simple à dépanner que tous les processus sur le même VPS.